Game-based assessments zijn geen gimmick, maar ook geen bewezen vervanging van klassieke cognitieve tests. Een meta-analyse over 44 publicaties vond een samenhang van r = 0,30 met traditionele tests, en r = 0,45 na correctie voor meetfout. Dat is een gemiddeld verband. Of een game werkprestatie voorspelt, is voor de meeste producten nog niet onafhankelijk aangetoond.
Dit artikel is voor CHRO's, HR-directeuren en talent acquisition leads die een game-based assessment overwegen of net een demo hebben gezien. Je leest wat het onderzoek zegt, hoe je de effectgroottes leest, waar het bewijs dun wordt en welk bewijs je vraagt voordat je een game inzet in een selectieproces met juridisch en reputatierisico. De kern is simpel. Validiteit hoort bij een specifieke score voor een specifiek selectiebesluit, niet bij een format. Een game die werkt voor één functie, één scoringsmodel en één doelgroep, zegt weinig over het volgende product in een demo.
Een game-based assessment (GBA) gebruikt spelmechanieken, zoals opdrachten op tijd, keuzes met beperkte middelen, patroontaken of risicobeslissingen, om gedrag uit te lokken dat wordt gescoord op een vooraf vastgelegd construct. In de wetenschappelijke literatuur zie je ook de term game-related assessment (GRA). Serious games assessment gaat over games die voor een ander doel dan vermaak zijn gebouwd.
Het onderscheid dat telt, is dat tussen een game die eruitziet als een game en een game die iets meet. Een visueel aantrekkelijke opdracht met willekeurige scoring heeft geen psychometrische waarde. Een opdracht die is ontworpen om werkgeheugen, abstract redeneren of leersnelheid zichtbaar te maken, met scoring die op bewijs rust, kan die waarde wel hebben.
Klassieke tests, zoals numerieke of verbale redeneertoetsen op tijd, hebben tientallen jaren validatie achter zich. Games hebben een kortere staat van dienst. Dat verschil in bewijs is een redelijke reden voor scepsis. Het format zelf is dat niet.
De bruikbaarste losse bron is een meta-analyse in het Journal of Intelligence (open access via PMC) naar de relatie tussen game-related assessments en traditionele metingen van cognitieve capaciteit. Die bundelt 44 publicaties en 52 steekproeven, met 807 effectgroottes en ruim 6.100 volwassen deelnemers.
De gemiddelde geobserveerde correlatie tussen games en traditionele cognitieve tests was r = 0,30. Na correctie voor meetfout kwam die uit op r = 0,45.
Wat betekent dat voor werving? Een correlatie van 0,30 tot 0,45 is een gemiddeld verband. Games en klassieke tests overlappen duidelijk, dus games meten niet niks. Uitwisselbaar zijn ze ook niet. Twee cognitieve tests die hetzelfde meten, zouden veel sterker met elkaar samenhangen. Het resultaat past bij games die een deel van algemene cognitieve capaciteit meten, plus andere dingen zoals motivatie, gewenning aan de interface, risicovoorkeur of taakspecifieke vaardigheid.
Een studie in Frontiers in Psychology (via PMC) naar game-based assessments van cognitieve capaciteit in recruitment kijkt naar validiteit, eerlijkheid en testervaring in een echte wervingscontext. Ze vond een test-hertestbetrouwbaarheid van r = 0,68, een convergente validiteit van r = 0,50 met traditionele cognitieve tests en een Net Promoter Score van 58 voor de testervaring. Voor eerlijkheid gebruikt de studie scoring met machine learning, namelijk ridge regressie met een ingebouwde straf op bias.
Dat zijn degelijke cijfers, en de aandacht voor adverse impact is een goed voorbeeld voor het vak. Er zijn wel twee kanttekeningen. De studie onderzoekt één aanpak uit één ecosysteem, dus je kunt de uitkomst niet doortrekken naar de hele categorie. En het belangrijkste validiteitsbewijs is samenhang met cognitieve tests, niet het voorspellen van werkprestatie.
Een derde meta-analyse, in het International Journal of Serious Games, gaat expliciet over de convergente validiteit van game-based assessments. Die afbakening is precies het punt. Convergente validiteit gaat over de vraag of een game samenhangt met andere metingen van hetzelfde construct. Of scores voorspellen wie goed presteert in de functie, is een andere vraag.
Elke bron beantwoordt een andere vraag. De constructen verschillen (redeneren, geheugen, aandacht, eigenschappen die tegen persoonlijkheid aan liggen). De scoringsmodellen ook. Een transparante puntenscore gedraagt zich anders dan een samengestelde score uit machine learning. Steekproeven verschillen in leeftijd, opleiding, taal en ervaring met games. Een gemiddelde van r = 0,45 is dus een gemiddelde over heel verschillende games, en losse producten scoren erboven en eronder.
De Standards for Educational and Psychological Testing (AERA, APA en NCME, 2014) zien validiteit als één begrip. Er zijn geen losse soorten validiteit die je kunt afvinken. Meerdere bronnen van bewijs onderbouwen samen of een score past bij het beoogde gebruik. Het gaat om deze vijf.
Hetzelfde kader geldt voor een verbale redeneertoets van veertig jaar oud en voor een nieuwe game. Een nieuw format krijgt geen vrijstelling. Dat is ook het standpunt van SIOP in haar richtlijnen voor het valideren van selectieprocedures. Het bewijs moet de specifieke conclusie in de specifieke context onderbouwen.
Betrouwbaarheid is hoe consistent een score is. In selectie zijn instabiele scores een direct risico. Als een kandidaat op een andere dag anders zou scoren om redenen die niets met capaciteit te maken hebben, dan zijn besluiten op basis van die score deels toeval.
De test-hertestcorrelatie van r = 0,68 uit de recruitmentstudie is acceptabel voor een game, maar ligt onder wat je verwacht van volwassen cognitieve tests voor besluiten met hoge inzet. Daar zijn betrouwbaarheden van 0,80 en hoger gebruikelijk. Voor een screeningsfase met menselijke beoordeling erna kan 0,68 verdedigbaar zijn. Voor een zelfstandige afkapgrens is het mager. Vraag leveranciers welke betrouwbaarheid ze rapporteren (test-hertest, interne consistentie, parallelle versies), over welke periode en in welke steekproef.
Hier is het bewijs het sterkst. De r = 0,30 geobserveerd en 0,45 gecorrigeerd uit de meta-analyse, en de r = 0,50 uit de recruitmentstudie, laten echte overlap met cognitieve capaciteit zien. Praktisch gezegd deelt een game met r = 0,50 ongeveer een kwart van zijn variantie met een klassieke test (r in het kwadraat is 0,25). De rest is iets anders. Dat kan relevant signaal zijn, ruis of een vaardigheid die er voor de functie niet toe doet. Alleen aanvullend bewijs maakt duidelijk welke van de drie.
Veel bezwaren van inkopers komen voort uit het door elkaar halen van twee claims.
Een gemiddelde convergente correlatie bewijst niet dat een game werkprestatie voorspelt. De gepubliceerde literatuur is veel sterker op het eerste dan op het tweede. Criteriumbewijs voor games in echte functies is schaarser en zit vaak in eigen of door de leverancier betaalde studies.
Er is een indirecte redenering. Als een game cognitieve capaciteit meet, en cognitieve capaciteit voorspelt prestatie (zoals decennia onderzoek naar klassieke tests laat zien), dan erft de game een deel van die voorspellende kracht. Maar die redenering verliest bij elke stap aan kracht. Een game die 0,45 samenhangt met het construct, voorspelt minder dan de klassieke test zelf, tenzij hij ook iets extra's meet dat in het werk telt. Behandel de indirecte redenering als een hypothese die je lokaal toetst, niet als conclusie.
Bewijs over responsprocessen gaat over de vraag of kandidaten doen wat de ontwerper aanneemt. Een hoge score kan ook komen door snelle reacties, bekendheid met spelconventies of een aangeleerde truc voor de interface, in plaats van door redeneren. Leveranciers kunnen dit onderbouwen met hardop-denkstudies, analyse van procesdata of door te laten zien dat scores overeind blijven na correctie voor game-ervaring en type apparaat.
Games zijn het best te verdedigen als drie voorwaarden kloppen. Het gemeten construct past bij wat de functie vraagt. De leverancier laat betrouwbaarheid en convergent bewijs op een acceptabel niveau zien. En er is criteriumvalidatie voor vergelijkbare functies, eerst van de leverancier en daarna lokaal bevestigd. Ontbreekt er één, gebruik de game dan als één input naast andere en niet als poort.
Zo zet Selection Lab het format in. Games zitten in een flow die per functie wordt samengesteld, naast andere assessmenttypen en gestructureerde interviewrondes, en niet als losse noviteit. Eén instrument draagt zelden in zijn eentje een selectiebesluit, en een combinatie van methoden is in de regel beter te verdedigen dan leunen op één meting.
Generaliseerbaarheid. De steekproeven in gepubliceerd onderzoek bestaan vooral uit volwassenen, vaak studenten of de algemene bevolking, en zijn zelden uitgesplitst naar senioriteit, cultuur of beschermde groep. Of de uitkomsten ook voor andere functies gelden, is grotendeels niet onderzocht.
Criteriumbewijs. Convergent bewijs overheerst. Onafhankelijke, peer-reviewed studies die gamescores koppelen aan beoordelingen van leidinggevenden, productiviteit of behoud zijn schaars.
Transparantie van scoring. Scoring met machine learning kan de voorspelling verbeteren en ruimte geven voor eerlijkheidseisen, zoals de straf op bias uit de recruitmentstudie. Het maakt scores ook lastiger uit te leggen. Bij een audit of bezwaar is ‘het model woog het zo’ geen verweer. Leveranciers moeten audit trails leveren, uitleg per kenmerk waar dat kan, en analyses per subgroep.
Operationele verstoringen. Oefeneffecten, verschillen tussen apparaten en coaching kunnen scores verschuiven. Dat vraagt om monitoring na de invoering, niet alleen in de oorspronkelijke validatie. Hoe je fraude en faken herkent, lees je in game-based assessments versus vragenlijsten.
Onafhankelijkheid van bronnen. Een deel van de studies die het meest relevant zijn voor de praktijk, komt uit commerciële ecosystemen. Dat maakt ze niet ongeldig, maar onafhankelijke replicatie en transparante methoden wegen daardoor zwaarder.
Een demovideo is geen bewijs. Vraag om een validiteitsdossier dat aansluit op de vijf bronnen van bewijs hierboven.
Gebruik de vier-vijfderegel (80 procent) als eerste toets. Ligt de selectieratio van een groep onder 80 procent van die van de groep met de hoogste ratio, dan geldt de procedure onder de Amerikaanse Uniform Guidelines als mogelijk nadelig. In het Verenigd Koninkrijk en de EU gelden andere juridische toetsen, maar de vier-vijfderatio blijft een veelgebruikte vuistregel voor monitoring bij cognitieve tests en andere selectie-instrumenten. Zie het als aanleiding om te onderzoeken en bij te sturen, niet als oordeel. Eis vastgelegde maatregelen en herhaal de analyse op je eigen sollicitantendata, niet alleen op die van de leverancier.
Vraag documentatie op over gegevensbescherming, bewaartermijnen, auditlogs en menselijk toezicht op geautomatiseerde besluiten. Voor Europese werkgevers gaat dat over de AVG en de EU AI Act, waaronder recruitmenttools als hoog risico gelden. Selection Lab geeft aan AVG-conform te werken en aan te sluiten op de EU AI Act, met persoonsgegevens opgeslagen in Frankfurt en lokale taalmodellen die persoonsgegevens uit gesprekken verwijderen. Welke leverancier je ook kiest, vraag de documentatie achter zulke claims op.
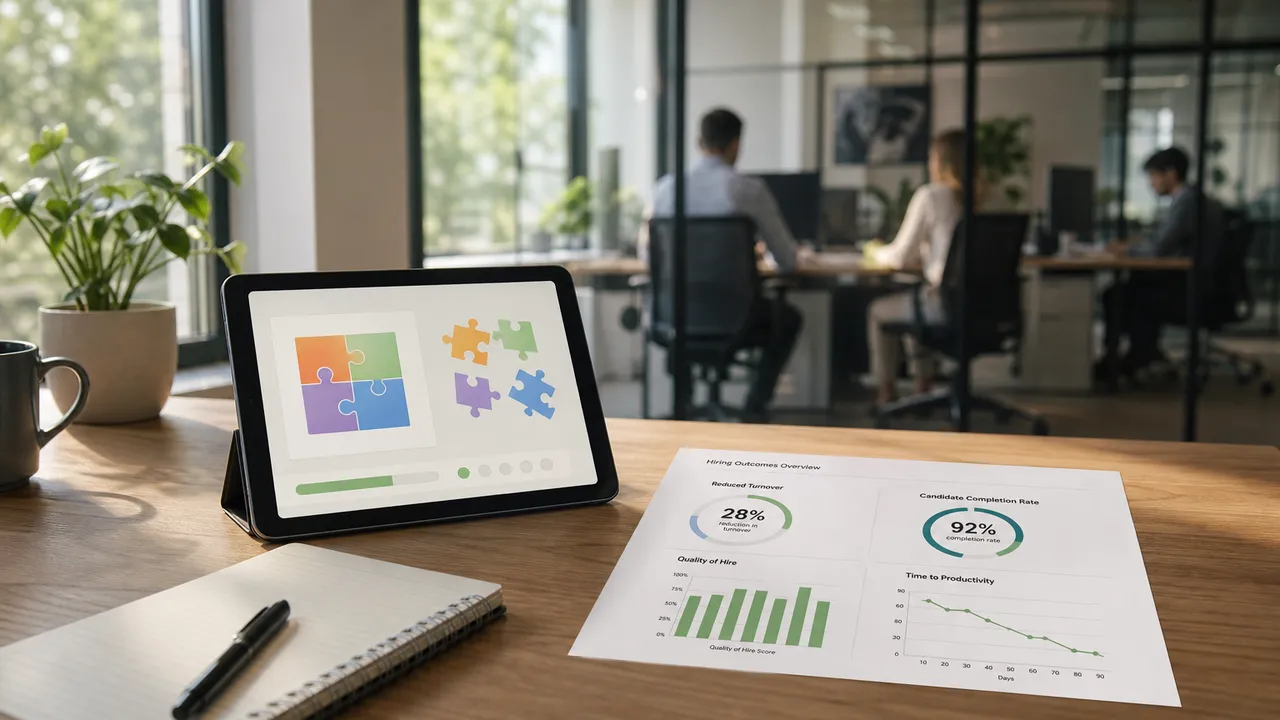
Pilot met één afgebakende functie voordat je opschaalt. Verzamel gamescores naast je bestaande selectiedata en, na een passende periode, data over prestatie en vroeg verloop. Monitor tussendoor de selectieratio's per subgroep. Klantuitkomsten die Selection Lab rapporteert, zoals 21 procent minder vroeg verloop (januari 2024) en 15 minuten tijdwinst per sollicitant (december 2025), laten zien welke operationele maten het volgen waard zijn. Het zijn wel cijfers van de leverancier zelf, en je pilot hoort je eigen nulmeting op te leveren.
Integratie telt ook mee. Selection Lab noemt een ATS-koppeling en een livegang binnen twee tot tien weken, wat een pilot met een vaste looptijd haalbaar maakt. Spreek bij elke leverancier af dat de pilotdata voor jou beschikbaar blijven voor eigen analyse. Wil je zien hoe dat bij Selection Lab werkt? Vraag een demo aan.
Het bewijs ondersteunt een gematigde conclusie. Games hangen gemiddeld samen met klassieke cognitieve tests, en minstens één recruitmentstudie rapporteert acceptabele betrouwbaarheid en een sterke kandidaatervaring. Wie dat een gimmick noemt, negeert de data. Wie het gelijkstelt aan een gevalideerde klassieke test, negeert wat ontbreekt. Dat is criteriumbewijs, onafhankelijke replicatie en bewijs over eerlijkheid voor jouw eigen kandidaten.
Gamen is niet het meten. Het validiteitsbewijs is dat wel. Koop eerst het bewijs, en pas daarna het format.
Goed gebouwde games kunnen voldoende betrouwbaar zijn. Een recruitmentstudie in Frontiers in Psychology vond een test-hertestbetrouwbaarheid van r = 0,68. Dat is acceptabel voor een screeningsfase met menselijke beoordeling erna, maar lager dan de 0,80 en hoger die gangbaar is voor klassieke cognitieve tests bij besluiten met hoge inzet.
Dat is voor de meeste games nog niet onafhankelijk aangetoond. Het gepubliceerde bewijs gaat vooral over samenhang met cognitieve tests, r = 0,30 tot 0,45 in een meta-analyse over 44 publicaties. Studies die gamescores koppelen aan werkprestatie zijn schaars en vaak door leveranciers zelf uitgevoerd. Toets het daarom lokaal met een pilot.
Convergente validiteit zegt of een game samenhangt met andere tests die hetzelfde meten. Predictieve validiteit zegt of de scores voorspellen wie goed presteert, een opleiding haalt of blijft. Een game kan het eerste hebben zonder dat het tweede bewezen is.
Een validiteitsdossier met een definitie van wat de game meet, betrouwbaarheidscijfers met steekproef en methode, correlaties met gevestigde cognitieve tests, samenhang met werkprestatie in vergelijkbare functies, selectieratio's per subgroep en data over kandidaatervaring. Een demovideo is geen bewijs.
Een eerste toets op mogelijke benadeling. Ligt de selectieratio van een groep onder 80 procent van die van de groep met de hoogste ratio, dan is dat een signaal om te onderzoeken. De regel komt uit de Amerikaanse Uniform Guidelines. In Europa gelden andere juridische toetsen, maar de ratio is een gangbare vuistregel voor monitoring.


Game-based assessments zijn geen gimmick, maar ook geen bewezen vervanging van klassieke cognitieve tests. Een meta-analyse over 44 publicaties vond een samenhang van r = 0,30 met traditionele tests, en r = 0,45 na correctie voor meetfout. Dat is een gemiddeld verband. Of een game werkprestatie voorspelt, is voor de meeste producten nog niet onafhankelijk aangetoond.
Dit artikel is voor CHRO's, HR-directeuren en talent acquisition leads die een game-based assessment overwegen of net een demo hebben gezien. Je leest wat het onderzoek zegt, hoe je de effectgroottes leest, waar het bewijs dun wordt en welk bewijs je vraagt voordat je een game inzet in een selectieproces met juridisch en reputatierisico. De kern is simpel. Validiteit hoort bij een specifieke score voor een specifiek selectiebesluit, niet bij een format. Een game die werkt voor één functie, één scoringsmodel en één doelgroep, zegt weinig over het volgende product in een demo.
Een game-based assessment (GBA) gebruikt spelmechanieken, zoals opdrachten op tijd, keuzes met beperkte middelen, patroontaken of risicobeslissingen, om gedrag uit te lokken dat wordt gescoord op een vooraf vastgelegd construct. In de wetenschappelijke literatuur zie je ook de term game-related assessment (GRA). Serious games assessment gaat over games die voor een ander doel dan vermaak zijn gebouwd.
Het onderscheid dat telt, is dat tussen een game die eruitziet als een game en een game die iets meet. Een visueel aantrekkelijke opdracht met willekeurige scoring heeft geen psychometrische waarde. Een opdracht die is ontworpen om werkgeheugen, abstract redeneren of leersnelheid zichtbaar te maken, met scoring die op bewijs rust, kan die waarde wel hebben.
Klassieke tests, zoals numerieke of verbale redeneertoetsen op tijd, hebben tientallen jaren validatie achter zich. Games hebben een kortere staat van dienst. Dat verschil in bewijs is een redelijke reden voor scepsis. Het format zelf is dat niet.
De bruikbaarste losse bron is een meta-analyse in het Journal of Intelligence (open access via PMC) naar de relatie tussen game-related assessments en traditionele metingen van cognitieve capaciteit. Die bundelt 44 publicaties en 52 steekproeven, met 807 effectgroottes en ruim 6.100 volwassen deelnemers.
De gemiddelde geobserveerde correlatie tussen games en traditionele cognitieve tests was r = 0,30. Na correctie voor meetfout kwam die uit op r = 0,45.
Wat betekent dat voor werving? Een correlatie van 0,30 tot 0,45 is een gemiddeld verband. Games en klassieke tests overlappen duidelijk, dus games meten niet niks. Uitwisselbaar zijn ze ook niet. Twee cognitieve tests die hetzelfde meten, zouden veel sterker met elkaar samenhangen. Het resultaat past bij games die een deel van algemene cognitieve capaciteit meten, plus andere dingen zoals motivatie, gewenning aan de interface, risicovoorkeur of taakspecifieke vaardigheid.
Een studie in Frontiers in Psychology (via PMC) naar game-based assessments van cognitieve capaciteit in recruitment kijkt naar validiteit, eerlijkheid en testervaring in een echte wervingscontext. Ze vond een test-hertestbetrouwbaarheid van r = 0,68, een convergente validiteit van r = 0,50 met traditionele cognitieve tests en een Net Promoter Score van 58 voor de testervaring. Voor eerlijkheid gebruikt de studie scoring met machine learning, namelijk ridge regressie met een ingebouwde straf op bias.
Dat zijn degelijke cijfers, en de aandacht voor adverse impact is een goed voorbeeld voor het vak. Er zijn wel twee kanttekeningen. De studie onderzoekt één aanpak uit één ecosysteem, dus je kunt de uitkomst niet doortrekken naar de hele categorie. En het belangrijkste validiteitsbewijs is samenhang met cognitieve tests, niet het voorspellen van werkprestatie.
Een derde meta-analyse, in het International Journal of Serious Games, gaat expliciet over de convergente validiteit van game-based assessments. Die afbakening is precies het punt. Convergente validiteit gaat over de vraag of een game samenhangt met andere metingen van hetzelfde construct. Of scores voorspellen wie goed presteert in de functie, is een andere vraag.
Elke bron beantwoordt een andere vraag. De constructen verschillen (redeneren, geheugen, aandacht, eigenschappen die tegen persoonlijkheid aan liggen). De scoringsmodellen ook. Een transparante puntenscore gedraagt zich anders dan een samengestelde score uit machine learning. Steekproeven verschillen in leeftijd, opleiding, taal en ervaring met games. Een gemiddelde van r = 0,45 is dus een gemiddelde over heel verschillende games, en losse producten scoren erboven en eronder.
De Standards for Educational and Psychological Testing (AERA, APA en NCME, 2014) zien validiteit als één begrip. Er zijn geen losse soorten validiteit die je kunt afvinken. Meerdere bronnen van bewijs onderbouwen samen of een score past bij het beoogde gebruik. Het gaat om deze vijf.
Hetzelfde kader geldt voor een verbale redeneertoets van veertig jaar oud en voor een nieuwe game. Een nieuw format krijgt geen vrijstelling. Dat is ook het standpunt van SIOP in haar richtlijnen voor het valideren van selectieprocedures. Het bewijs moet de specifieke conclusie in de specifieke context onderbouwen.
Betrouwbaarheid is hoe consistent een score is. In selectie zijn instabiele scores een direct risico. Als een kandidaat op een andere dag anders zou scoren om redenen die niets met capaciteit te maken hebben, dan zijn besluiten op basis van die score deels toeval.
De test-hertestcorrelatie van r = 0,68 uit de recruitmentstudie is acceptabel voor een game, maar ligt onder wat je verwacht van volwassen cognitieve tests voor besluiten met hoge inzet. Daar zijn betrouwbaarheden van 0,80 en hoger gebruikelijk. Voor een screeningsfase met menselijke beoordeling erna kan 0,68 verdedigbaar zijn. Voor een zelfstandige afkapgrens is het mager. Vraag leveranciers welke betrouwbaarheid ze rapporteren (test-hertest, interne consistentie, parallelle versies), over welke periode en in welke steekproef.
Hier is het bewijs het sterkst. De r = 0,30 geobserveerd en 0,45 gecorrigeerd uit de meta-analyse, en de r = 0,50 uit de recruitmentstudie, laten echte overlap met cognitieve capaciteit zien. Praktisch gezegd deelt een game met r = 0,50 ongeveer een kwart van zijn variantie met een klassieke test (r in het kwadraat is 0,25). De rest is iets anders. Dat kan relevant signaal zijn, ruis of een vaardigheid die er voor de functie niet toe doet. Alleen aanvullend bewijs maakt duidelijk welke van de drie.
Veel bezwaren van inkopers komen voort uit het door elkaar halen van twee claims.
Een gemiddelde convergente correlatie bewijst niet dat een game werkprestatie voorspelt. De gepubliceerde literatuur is veel sterker op het eerste dan op het tweede. Criteriumbewijs voor games in echte functies is schaarser en zit vaak in eigen of door de leverancier betaalde studies.
Er is een indirecte redenering. Als een game cognitieve capaciteit meet, en cognitieve capaciteit voorspelt prestatie (zoals decennia onderzoek naar klassieke tests laat zien), dan erft de game een deel van die voorspellende kracht. Maar die redenering verliest bij elke stap aan kracht. Een game die 0,45 samenhangt met het construct, voorspelt minder dan de klassieke test zelf, tenzij hij ook iets extra's meet dat in het werk telt. Behandel de indirecte redenering als een hypothese die je lokaal toetst, niet als conclusie.
Bewijs over responsprocessen gaat over de vraag of kandidaten doen wat de ontwerper aanneemt. Een hoge score kan ook komen door snelle reacties, bekendheid met spelconventies of een aangeleerde truc voor de interface, in plaats van door redeneren. Leveranciers kunnen dit onderbouwen met hardop-denkstudies, analyse van procesdata of door te laten zien dat scores overeind blijven na correctie voor game-ervaring en type apparaat.
Games zijn het best te verdedigen als drie voorwaarden kloppen. Het gemeten construct past bij wat de functie vraagt. De leverancier laat betrouwbaarheid en convergent bewijs op een acceptabel niveau zien. En er is criteriumvalidatie voor vergelijkbare functies, eerst van de leverancier en daarna lokaal bevestigd. Ontbreekt er één, gebruik de game dan als één input naast andere en niet als poort.
Zo zet Selection Lab het format in. Games zitten in een flow die per functie wordt samengesteld, naast andere assessmenttypen en gestructureerde interviewrondes, en niet als losse noviteit. Eén instrument draagt zelden in zijn eentje een selectiebesluit, en een combinatie van methoden is in de regel beter te verdedigen dan leunen op één meting.
Generaliseerbaarheid. De steekproeven in gepubliceerd onderzoek bestaan vooral uit volwassenen, vaak studenten of de algemene bevolking, en zijn zelden uitgesplitst naar senioriteit, cultuur of beschermde groep. Of de uitkomsten ook voor andere functies gelden, is grotendeels niet onderzocht.
Criteriumbewijs. Convergent bewijs overheerst. Onafhankelijke, peer-reviewed studies die gamescores koppelen aan beoordelingen van leidinggevenden, productiviteit of behoud zijn schaars.
Transparantie van scoring. Scoring met machine learning kan de voorspelling verbeteren en ruimte geven voor eerlijkheidseisen, zoals de straf op bias uit de recruitmentstudie. Het maakt scores ook lastiger uit te leggen. Bij een audit of bezwaar is ‘het model woog het zo’ geen verweer. Leveranciers moeten audit trails leveren, uitleg per kenmerk waar dat kan, en analyses per subgroep.
Operationele verstoringen. Oefeneffecten, verschillen tussen apparaten en coaching kunnen scores verschuiven. Dat vraagt om monitoring na de invoering, niet alleen in de oorspronkelijke validatie. Hoe je fraude en faken herkent, lees je in game-based assessments versus vragenlijsten.
Onafhankelijkheid van bronnen. Een deel van de studies die het meest relevant zijn voor de praktijk, komt uit commerciële ecosystemen. Dat maakt ze niet ongeldig, maar onafhankelijke replicatie en transparante methoden wegen daardoor zwaarder.
Een demovideo is geen bewijs. Vraag om een validiteitsdossier dat aansluit op de vijf bronnen van bewijs hierboven.
Gebruik de vier-vijfderegel (80 procent) als eerste toets. Ligt de selectieratio van een groep onder 80 procent van die van de groep met de hoogste ratio, dan geldt de procedure onder de Amerikaanse Uniform Guidelines als mogelijk nadelig. In het Verenigd Koninkrijk en de EU gelden andere juridische toetsen, maar de vier-vijfderatio blijft een veelgebruikte vuistregel voor monitoring bij cognitieve tests en andere selectie-instrumenten. Zie het als aanleiding om te onderzoeken en bij te sturen, niet als oordeel. Eis vastgelegde maatregelen en herhaal de analyse op je eigen sollicitantendata, niet alleen op die van de leverancier.
Vraag documentatie op over gegevensbescherming, bewaartermijnen, auditlogs en menselijk toezicht op geautomatiseerde besluiten. Voor Europese werkgevers gaat dat over de AVG en de EU AI Act, waaronder recruitmenttools als hoog risico gelden. Selection Lab geeft aan AVG-conform te werken en aan te sluiten op de EU AI Act, met persoonsgegevens opgeslagen in Frankfurt en lokale taalmodellen die persoonsgegevens uit gesprekken verwijderen. Welke leverancier je ook kiest, vraag de documentatie achter zulke claims op.
Pilot met één afgebakende functie voordat je opschaalt. Verzamel gamescores naast je bestaande selectiedata en, na een passende periode, data over prestatie en vroeg verloop. Monitor tussendoor de selectieratio's per subgroep. Klantuitkomsten die Selection Lab rapporteert, zoals 21 procent minder vroeg verloop (januari 2024) en 15 minuten tijdwinst per sollicitant (december 2025), laten zien welke operationele maten het volgen waard zijn. Het zijn wel cijfers van de leverancier zelf, en je pilot hoort je eigen nulmeting op te leveren.
Integratie telt ook mee. Selection Lab noemt een ATS-koppeling en een livegang binnen twee tot tien weken, wat een pilot met een vaste looptijd haalbaar maakt. Spreek bij elke leverancier af dat de pilotdata voor jou beschikbaar blijven voor eigen analyse. Wil je zien hoe dat bij Selection Lab werkt? Vraag een demo aan.
Het bewijs ondersteunt een gematigde conclusie. Games hangen gemiddeld samen met klassieke cognitieve tests, en minstens één recruitmentstudie rapporteert acceptabele betrouwbaarheid en een sterke kandidaatervaring. Wie dat een gimmick noemt, negeert de data. Wie het gelijkstelt aan een gevalideerde klassieke test, negeert wat ontbreekt. Dat is criteriumbewijs, onafhankelijke replicatie en bewijs over eerlijkheid voor jouw eigen kandidaten.
Gamen is niet het meten. Het validiteitsbewijs is dat wel. Koop eerst het bewijs, en pas daarna het format.
Goed gebouwde games kunnen voldoende betrouwbaar zijn. Een recruitmentstudie in Frontiers in Psychology vond een test-hertestbetrouwbaarheid van r = 0,68. Dat is acceptabel voor een screeningsfase met menselijke beoordeling erna, maar lager dan de 0,80 en hoger die gangbaar is voor klassieke cognitieve tests bij besluiten met hoge inzet.
Dat is voor de meeste games nog niet onafhankelijk aangetoond. Het gepubliceerde bewijs gaat vooral over samenhang met cognitieve tests, r = 0,30 tot 0,45 in een meta-analyse over 44 publicaties. Studies die gamescores koppelen aan werkprestatie zijn schaars en vaak door leveranciers zelf uitgevoerd. Toets het daarom lokaal met een pilot.
Convergente validiteit zegt of een game samenhangt met andere tests die hetzelfde meten. Predictieve validiteit zegt of de scores voorspellen wie goed presteert, een opleiding haalt of blijft. Een game kan het eerste hebben zonder dat het tweede bewezen is.
Een validiteitsdossier met een definitie van wat de game meet, betrouwbaarheidscijfers met steekproef en methode, correlaties met gevestigde cognitieve tests, samenhang met werkprestatie in vergelijkbare functies, selectieratio's per subgroep en data over kandidaatervaring. Een demovideo is geen bewijs.
Een eerste toets op mogelijke benadeling. Ligt de selectieratio van een groep onder 80 procent van die van de groep met de hoogste ratio, dan is dat een signaal om te onderzoeken. De regel komt uit de Amerikaanse Uniform Guidelines. In Europa gelden andere juridische toetsen, maar de ratio is een gangbare vuistregel voor monitoring.