Bias in AI-werving monitor je door per kandidaatgroep en per beslismoment de selectieratio te berekenen en die te toetsen aan de viervijfderegel. Elk verschil bevestig je daarna met een statistische toets, een betrouwbaarheidsinterval en een effectgrootte. Dat doe je per batch sollicitanten en niet eenmalig, want kandidatenpools, drempels en beoordelingscriteria veranderen voortdurend.
Bias in geautomatiseerde selectie kondigt zich zelden aan. Een model dat gemiddeld nauwkeurig scoort, kan kandidaten uit beschermde groepen op elk beslismoment in de funnel toch structureel benadelen. Tussen "het systeem werkt" en "het systeem werkt eerlijk" zit precies de ruimte waarin nadelige impact (adverse impact) ontstaat. Die ruimte dicht je niet met één audit voor de livegang, maar met doorlopend meten.
Dit draaiboek is geschreven voor HR- en recruitmentleads, compliance-eigenaren en iedereen die verantwoordelijk is voor de eerlijkheid van een AI-selectietool in productie. Welke metrics je berekent, welke toetsen je draait, hoe je uitkomsten leest als er onzekerheid in zit, en hoe doorlopende monitoring er als vaste controle uitziet.
Meten en ingrijpen zijn twee verschillende dingen, en ze door elkaar halen is de meest gemaakte fout. Meten betekent vaststellen of er een verschil is en hoe groot dat is, met statistische zekerheid. Ingrijpen betekent beslissen wat je eraan doet. Het tweede kun je niet verantwoord doen zonder het eerste.
Nadelige impact gaat over verschillen in selectieratio tussen beschermde groepen die op een risico van discriminatie wijzen, los van de bedoeling. In het Amerikaanse kader van de EEOC kan een selectieproces waarin een beschermde groep duidelijk minder vaak doorgaat al als disparate impact gelden, ook als de afzonderlijke testitems neutraal lijken. Volgens een samenvatting van Reuters en Practical Law uit 2023 geldt die logica ook voor AI-tools. Het gaat om verschillen in uitkomst die statistisch zijn onderbouwd, niet om intentie of gemiddelde nauwkeurigheid.
Monitoren na de livegang is nodig omdat de omstandigheden veranderen. De instroom verschuift per seizoen en per wervingskanaal. Beoordelingscriteria worden bijgewerkt. Scoredrempels gaan omhoog of omlaag om zakelijke redenen. Elke wijziging kan de uitkomsten per groep veranderen zonder dat er een alert afgaat. Het NIST AI Risk Management Framework (AI RMF 1.0, januari 2023) zegt het expliciet. MEASURE 2.4 vraagt om het gedrag en de output van AI-systemen in productie actief te volgen, zodat verschuivende foutpercentages of nadelige impact op tijd zichtbaar worden. De EU AI Act sluit daarop aan met artikel 72, dat aanbieders van hoog-risico AI een gedocumenteerd plan voor monitoring na het in de handel brengen oplegt. Wat jouw organisatie als gebruiker zelf regelt, lees je in onze uitleg over de EU AI Act voor gebruiksverantwoordelijken.
Voor je iets toetst, bepaal je je meeteenheid. Bereken metrics per functiefamilie, per functieniveau of per instroombatch, dus een afgebakende periode met sollicitanten die onder dezelfde assessmentconfiguratie zijn beoordeeld. Leg vast hoe je batches definieert, zodat elke meting te herhalen is. Voor stabiele uitkomsten is ongeveer 30 kandidaten per subgroep per batch een praktische ondergrens bij metrics op basis van proporties. Daaronder worden de betrouwbaarheidsintervallen te breed om op te handelen.
Selectieratio en de viervijfderegel. Bereken voor elke beschermde groep de selectieratio, dus het aantal geselecteerde kandidaten op een beslismoment gedeeld door het totale aantal sollicitanten uit die groep. Deel daarna de selectieratio van de groep die je bekijkt door die van de groep met de hoogste ratio. Ligt die verhouding onder 0,80, dan geeft de viervijfderegel uit de EEOC-richtlijnen een signaal van mogelijke nadelige impact en volgt een review. Dit geldt voor elke fase in de funnel. Het assessment, de shortlist, de uitnodiging voor een gesprek en de aanname.
Selectieratio per beslismoment. Kijk niet alleen naar de laatste stap. Een verschil dat bij de aanname klein lijkt, kan zich over meerdere eerdere selectiemomenten hebben opgebouwd. Volg de selectieratio op elk beslismoment apart.
Gemiddelde en mediane scores per subgroep. Geeft het assessment een doorlopende score, bereken dan per subgroep het gemiddelde en de mediaan met een 95%-betrouwbaarheidsinterval. Rapporteer Cohen's d als effectgrootte naast elke significantietoets. Effectgrootte telt, omdat een statistisch significant verschil in de praktijk klein kan zijn, en een groot verschil in kleine batches statistisch onzichtbaar kan blijven.
Kalibratie. Voorspelt de score functieprestatie, deel de scores dan op in tienden (decielen) en vergelijk per deciel de werkelijke uitkomsten tussen subgroepen. Denk aan behoud na 90 dagen, beoordelingen van de manager of het afronden van een training. Halen kandidaten uit groep A met een score van 70 tot 79 in 60% van de gevallen een goede uitkomst en kandidaten uit groep B in dezelfde band maar in 40%, dan is het model per groep verkeerd gekalibreerd. Elke vaste drempel geeft dan structureel ongelijke foutpercentages.
Foutpercentages per groep. Heb je een objectief criterium voor "geschikt", bereken dan per subgroep het percentage vals-positieven (ongeschikte kandidaten die doorgaan) en vals-negatieven (geschikte kandidaten die afvallen). Een gelijke nauwkeurigheid over het geheel kan scheve foutpercentages verbergen die één groep onevenredig raken.
De viervijfderegel is een vuistregel om te signaleren, geen statistische toets. In kleine batches geeft hij valse alarmen en in grote batches mist hij echte effecten. De statistische toets levert het bewijs.
Vergelijk je selectieratio's (door of niet door, twee groepen), gebruik dan een z-toets voor twee proporties, of Fisher's exacte toets bij kleine aantallen. Rapporteer de p-waarde, het 95%-betrouwbaarheidsinterval op het verschil in proporties en de odds ratio of het relatieve risico als effectgrootte.
Vergelijk je doorlopende scores, gebruik dan Welch's t-toets (die geen gelijke varianties veronderstelt) of de Mann-Whitney U-toets bij niet-normale verdelingen. Rapporteer Cohen's d met het betrouwbaarheidsinterval.
Toets je meerdere subgroepen, meerdere beslismomenten en meerdere functiefamilies tegelijk, dan neemt de kans op toevalstreffers snel toe. Pas een correctie toe voor meervoudig toetsen, zoals Benjamini-Hochberg of Bonferroni, en leg vast welke je kiest en waarom. Kies je bewust voor geen correctie, onderbouw dat dan. Bijvoorbeeld omdat een gemist signaal in jouw context zwaarder weegt dan een vals alarm.
Verdeel je beslislogica in drie niveaus.
Eén valkuil verdient extra aandacht. Proxykenmerken kunnen bias veroorzaken die je met gemiddelde nauwkeurigheid nooit ziet. Hangt een kenmerk samen met groepslidmaatschap, zoals postcode, bepaald taalgebruik of reactiesnelheid op bepaalde vraagtypes, dan kan het model nadelige impact geven terwijl de totale nauwkeurigheid er gezond uitziet. Daarom is uitsplitsen per groep, zoals NIST AI RMF MEASURE 2.2 voorschrijft, geen optie maar een vereiste. Welke subgroepcijfers je bij een leverancier opvraagt, staat in ons overzicht van wat een leverancier moet aanleveren bij een AI-audit.
Neem één instroombatch van 400 sollicitanten die een geautomatiseerd screeningsassessment doorlopen voor een logistieke functie. Je volgt twee subgroepen, groep A (200 sollicitanten) en groep B (200 sollicitanten).
Stap 1. De viervijfde-verhouding. Groep A komt voor 50% door (100 van 200). Groep B voor 35% (70 van 200). De verhouding is 0,35 gedeeld door 0,50, dus 0,70. Dat ligt onder 0,80, dus de viervijfderegel geeft een signaal van mogelijke nadelige impact. Niveau signaal bereikt.
Stap 2. De z-toets voor twee proporties. Het verschil in selectieratio is 0,15 (50% min 35%). De z-toets geeft z = 3,03 en p = 0,002. Het 95%-betrouwbaarheidsinterval op het verschil loopt van 0,05 tot 0,24 en sluit nul dus uit. Niveau onderzoek bereikt.
Stap 3. De effectgrootte. Omgerekend naar een odds ratio is dat (100/100) gedeeld door (70/130), dus 1,86. Kandidaten uit groep A hebben ruwweg 86% hogere odds om door te komen dan kandidaten uit groep B. Dat is een verschil dat er in de praktijk toe doet, geen statistisch toeval.
Stap 4. Gemiddelde scores met betrouwbaarheidsintervallen. Groep A scoort gemiddeld 68,2 (95%-interval 66,5 tot 69,9). Groep B scoort gemiddeld 62,7 (95%-interval 60,9 tot 64,5). De intervallen overlappen niet, dus het verschil is waarschijnlijk geen ruis. Cohen's d is 0,43, een middelgroot effect.
Stap 5. De kalibratiecheck. In de scoreband 60 tot 69 had groep A na aanname een behoud na zes maanden van 78%. Groep B in dezelfde band kwam op 75%. Daar zit geen betekenisvol kalibratieverschil. Dat wijst erop dat de drempel om door te gaan te hoog ligt, niet dat de score per groep verkeerd gekalibreerd is. Je hebt dus een drempelprobleem en geen trainingsprobleem.
Het niveau ingrijpen is bereikt. De passende reactie is de drempel herzien en nagaan of een lagere drempel voor alle kandidaten (niet alleen voor groep B) de functierelevantie behoudt en het verschil verkleint.
Elke monitoringronde levert een vast bewijsrecord op. Dit zijn de velden die je minimaal nodig hebt om je aanpak tegenover een toezichthouder te verdedigen.
| Veld | Inhoud |
|---|---|
| Batch-ID | Unieke code en periode |
| Definitie subgroep | Beschermd kenmerk en hoe het is verzameld of afgeleid |
| Assessmentversie | Naam van de tool, versie en configuratie |
| Steekproefgrootte | Aantal per subgroep |
| Selectieratio per subgroep | Exacte cijfers |
| Viervijfde-verhouding | Berekende waarde en signaal ja of nee |
| Toetsgrootheid en p-waarde | Soort toets, z-, F- of U-waarde en p-waarde |
| 95%-interval op het verschil | Onder- en bovengrens |
| Effectgrootte | Cohen's d, odds ratio of relatief risico |
| Uitkomst kalibratiecheck | In orde of signaal, per scoreband |
| Bereikt niveau | Signaal, onderzoek of ingrijpen |
| Genomen actie | Drempel aangepast, hertraind of opgeschaald naar menselijke review |
| Status | Open, in behandeling of gesloten |
Ingrijpen is niet altijd hertrainen. De juiste aanpak hangt af van waar in het systeem het verschil ontstaat.
Op het niveau van data en proces onderzoek je of elk onderdeel van het assessment echt iets zegt over de functie, of bepaalde wervingskanalen een scheve instroom opleveren, en of de formulering van prompts of beoordelingscriteria bepaalde taal- of demografische groepen bevoordeelt.
Op het niveau van het model kun je de drempel aanpassen (de meest gebruikte ingreep bij kalibratieproblemen), de data herwegen bij hertraining, de scores achteraf kalibreren, of trainen met een doel dat nadelige impact expliciet afstraft.
Op het niveau van beleid voer je een gestructureerde menselijke review in voor kandidaten die net rond de drempel scoren, richt je een formele bezwaar- en herstelprocedure in en leg je vast hoe je met uitzonderingen omgaat.
Leg je triggers vooraf vast, zodat beslissingen niet per geval worden genomen.
Volgt er een hertraining, dan moet je de fairness-uitkomsten van voor de hertraining kunnen reproduceren (zet data en code vast op versie), het nieuwe model voor release volledig testen, evalueren, verifiëren en valideren (TEVV), en vastleggen welke metric de hertraining uitlokte en of het nieuwe model het verschil oplost zonder de functierelevantie te verliezen.
Een monitoringjob in productie draait op een vast ritme, meestal maandelijks of per batch, en voedt zowel een dashboard als een auditlog. De stappen zijn deze.
1. Haal de pipelinedata op voor de batchperiode (kandidaat-ID's,
   subgroepkenmerken, beslisuitkomsten, scores, tijdstempels).
2. Bereken de selectieratio per subgroep per beslismoment.
3. Bereken de viervijfde-verhoudingen en markeer alles onder 0,80.
4. Draai de z-toets voor twee proporties (of Fisher exact bij n < 30)
   en bereken 95%-intervallen en odds ratios.
5. Bereken gemiddelde scores per subgroep, draai Welch's t-toets
   en bereken Cohen's d met het 95%-interval op het verschil.
6. Doe de kalibratiecheck, groepeer uitkomsten per scoredeciel
   en subgroep en vergelijk werkelijke met verwachte percentages.
7. Bereken driftindicatoren (PSI of KS per belangrijk kenmerk).
8. Schrijf alle uitkomsten met batchgegevens en assessmentversie
   weg naar het auditlog.
9. Zet alerts uit op het bereikte niveau.
In Python ziet de kern van de proportietoets er zo uit.
from statsmodels.stats.proportion import proportions_ztest, confint_proportions_2indep
from scipy.stats import fisher_exact

z, p = proportions_ztest([100, 70], [200, 200])

# 95%-betrouwbaarheidsinterval op het verschil
ci_low, ci_high = confint_proportions_2indep(
    100, 200, 70, 200, method="newcomb", alpha=0.05
)
Bij kleine steekproeven gebruik je fisher_exact([[100, 100], [70, 130]]) uit scipy.stats.
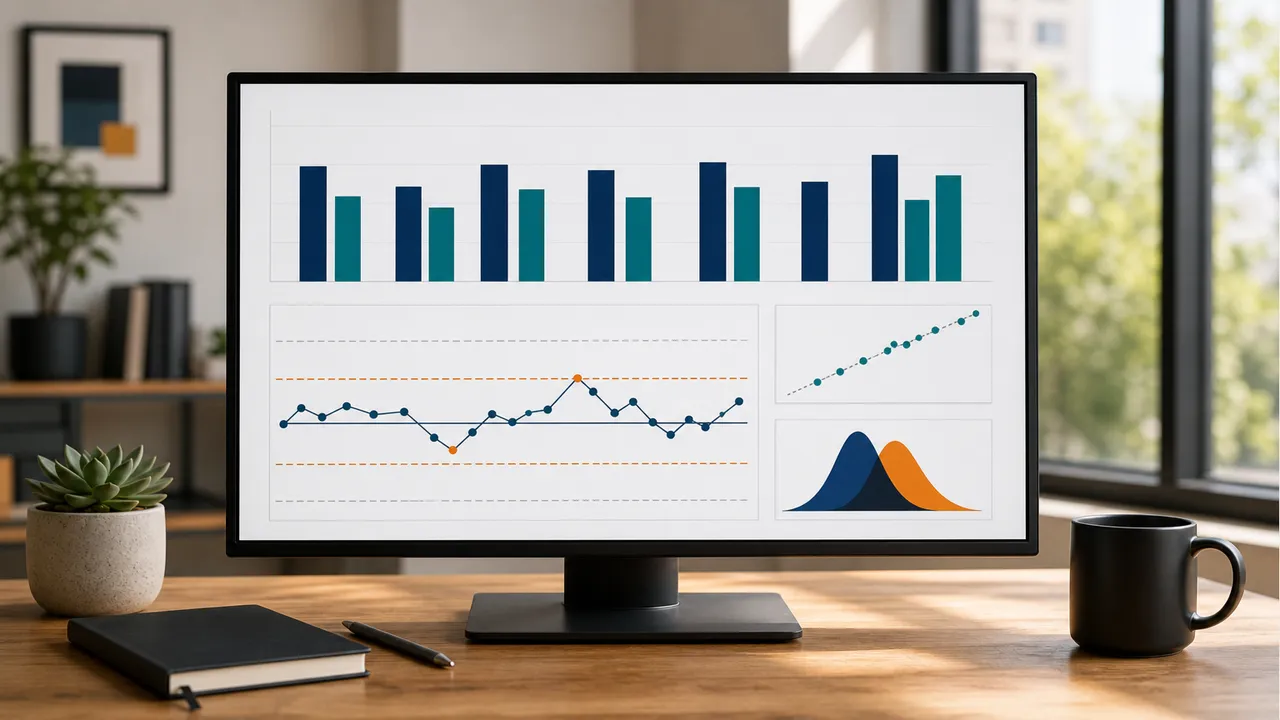
Een dashboard voor fairness-monitoring heeft vijf panelen.
Laat een alert pas doorstromen naar het niveau onderzoek als zowel de metric over de grens gaat als de toets het bevestigt. Een alert op alleen de viervijfde-verhouding in een batch van 40 sollicitanten is waarschijnlijk ruis. Een alert op de verhouding én een significante toets in een batch van 300 onderzoek je meteen.
Subgroepgegevens opslaan voor fairness-monitoring moet passen bij de AVG-beginselen van dataminimalisatie en doelbinding. In de praktijk bewaar je statistieken op batchniveau (aantallen, ratio's, toetsuitkomsten) en geen subgroepkenmerken per persoon langer dan de verwerking duurt. Pseudonimiseer kandidaatgegevens voor je analyses draait, leg bewaartermijnen voor ruwe scoredata vast en documenteer de grondslag voor het verwerken van bijzondere persoonsgegevens (meestal een specifieke uitzondering onder artikel 9 AVG voor gelijkheidsmonitoring). Of je daarvoor een DPIA nodig hebt, lees je in ons artikel over de DPIA bij AI-assessments.
Een platform dat met deze eisen is gebouwd, maakt dit een stuk eenvoudiger. Selection Lab slaat persoonsgegevens op in Frankfurt met bewaartermijnen volgens de AVG en gebruikt lokale taalmodellen om persoonlijke informatie uit gesprekslogs te halen voordat die verder worden verwerkt. Zo bouw je een audittrail voor fairness-monitoring zonder herleidbare bijzondere gegevens per kandidaat te bewaren, en dat is de juiste opzet voor een monitoringprogramma dat jaren meegaat. Omdat SmartChat direct koppelt met je ATS, wordt de funneldata op elk beslismoment op dezelfde manier vastgelegd. Compliance-teams hebben dan een gestructureerde databron om hun monitoring op te draaien, zonder losse exports.
Fairness-monitoring schuift vaak naar achteren omdat teams denken dat er eerst een groot dataproject nodig is. Dat klopt zelden. Een organisatie die een gestructureerd assessment invoert, kan binnen weken na de livegang selectieratio's berekenen en de eerste proportietoetsen draaien. Voorwaarde is dat je subgroepen, beslismomenten en batchperiodes bij de inrichting vastlegt en niet achteraf.
Bij Selection Lab duurt de implementatie doorgaans twee tot tien weken. In die periode richt je de monitoring parallel aan de uitrol in. Je zet het vastleggen van subgroepen in het ATS aan, bevestigt het schema van het auditlog en plant de eerste batchreview aan het eind van de eerste volledige instroomcyclus. Wie pas na de livegang aan monitoring denkt, mist bijna altijd de eerste batches.
De opbrengst is niet alleen compliance. Wie de eerlijkheid van de assessmentpipeline monitort, ziet ook waar de funnel lekt. Vallen kandidaten uit groep B vaker af bij het assessment dan de rest, dan is dat een mogelijk signaal van nadelige impact en tegelijk een probleem in de kandidaatervaring. De impactcijfers van Selection Lab laten zien hoe assessmentontwerp en screeningkwaliteit samenhangen. 27% minder uitval van sollicitanten (data van maart 2025) en 21% minder vroeg verloop (data van januari 2024) zijn het soort uitkomsten dat een goed ingericht monitoringprogramma vastlegt, koppelt aan proceswijzigingen en aan de juiste oorzaak toeschrijft.
Voldoen aan NIST AI RMF MEASURE 2.1 tot en met 2.4 en aan de monitoringverplichtingen uit artikel 72 van de EU AI Act vraagt om gedocumenteerd, reproduceerbaar bewijs, niet om losse rapporten. Het template hierboven geeft je de structuur. De monitoringpipeline zorgt voor de automatisering. Wat er een verdedigbare compliance-aanpak van maakt, is governance. Een eigenaar per metric, een vastgelegd escalatiepad van signaal tot ingrijpen, versiebeheer op assessmentconfiguraties en documentatie die elke ingreep terugkoppelt aan het statistische bewijs dat hem uitlokte.
De organisaties die het rustigst blijven bij toezicht zijn niet degene met de meeste audits. Het zijn de organisaties die doorlopend monitoren en per batch kunnen laten zien dat ze wisten wat hun systeem deed, afwijkingen onderzochten en op het bewijs handelden. Wil je zien hoe dat er in jouw selectieproces uitziet, vraag dan een demo aan.
De viervijfderegel vergelijkt selectieratio's tussen groepen. Ligt de selectieratio van een beschermde groep onder 80% van die van de groep met de hoogste ratio, dan is dat een signaal van mogelijke nadelige impact. Het is een vuistregel en geen bewijs. Bevestig het verschil altijd met een statistische toets en een effectgrootte.
Doorlopend, op een vast ritme. Meestal is dat maandelijks of per instroombatch. Een eenmalige audit voor de livegang is niet genoeg, omdat instroom, drempels en beoordelingscriteria veranderen en elke wijziging de uitkomsten per groep kan verschuiven.
Als praktische ondergrens ongeveer 30 kandidaten per subgroep per batch voor metrics op basis van proporties. Bij kleinere aantallen worden de betrouwbaarheidsintervallen te breed om op te handelen en gebruik je Fisher's exacte toets in plaats van de z-toets.
Niet altijd. Kijk eerst waar het verschil ontstaat. Vaak ligt de oplossing in een aangepaste drempel, een kalibratiecorrectie, een menselijke review rond de drempel of een ander wervingskanaal. Hertrainen is pas aan de orde als het model zelf de oorzaak is, en dan met volledige tests voor de release.
Ja, onder voorwaarden. Je hebt een grondslag nodig, meestal een uitzondering onder artikel 9 AVG voor gelijkheidsmonitoring. Bewaar bij voorkeur alleen statistieken op batchniveau, pseudonimiseer kandidaatgegevens voor de analyse en leg vaste bewaartermijnen vast.


Bias in AI-werving monitor je door per kandidaatgroep en per beslismoment de selectieratio te berekenen en die te toetsen aan de viervijfderegel. Elk verschil bevestig je daarna met een statistische toets, een betrouwbaarheidsinterval en een effectgrootte. Dat doe je per batch sollicitanten en niet eenmalig, want kandidatenpools, drempels en beoordelingscriteria veranderen voortdurend.
Bias in geautomatiseerde selectie kondigt zich zelden aan. Een model dat gemiddeld nauwkeurig scoort, kan kandidaten uit beschermde groepen op elk beslismoment in de funnel toch structureel benadelen. Tussen "het systeem werkt" en "het systeem werkt eerlijk" zit precies de ruimte waarin nadelige impact (adverse impact) ontstaat. Die ruimte dicht je niet met één audit voor de livegang, maar met doorlopend meten.
Dit draaiboek is geschreven voor HR- en recruitmentleads, compliance-eigenaren en iedereen die verantwoordelijk is voor de eerlijkheid van een AI-selectietool in productie. Welke metrics je berekent, welke toetsen je draait, hoe je uitkomsten leest als er onzekerheid in zit, en hoe doorlopende monitoring er als vaste controle uitziet.
Meten en ingrijpen zijn twee verschillende dingen, en ze door elkaar halen is de meest gemaakte fout. Meten betekent vaststellen of er een verschil is en hoe groot dat is, met statistische zekerheid. Ingrijpen betekent beslissen wat je eraan doet. Het tweede kun je niet verantwoord doen zonder het eerste.
Nadelige impact gaat over verschillen in selectieratio tussen beschermde groepen die op een risico van discriminatie wijzen, los van de bedoeling. In het Amerikaanse kader van de EEOC kan een selectieproces waarin een beschermde groep duidelijk minder vaak doorgaat al als disparate impact gelden, ook als de afzonderlijke testitems neutraal lijken. Volgens een samenvatting van Reuters en Practical Law uit 2023 geldt die logica ook voor AI-tools. Het gaat om verschillen in uitkomst die statistisch zijn onderbouwd, niet om intentie of gemiddelde nauwkeurigheid.
Monitoren na de livegang is nodig omdat de omstandigheden veranderen. De instroom verschuift per seizoen en per wervingskanaal. Beoordelingscriteria worden bijgewerkt. Scoredrempels gaan omhoog of omlaag om zakelijke redenen. Elke wijziging kan de uitkomsten per groep veranderen zonder dat er een alert afgaat. Het NIST AI Risk Management Framework (AI RMF 1.0, januari 2023) zegt het expliciet. MEASURE 2.4 vraagt om het gedrag en de output van AI-systemen in productie actief te volgen, zodat verschuivende foutpercentages of nadelige impact op tijd zichtbaar worden. De EU AI Act sluit daarop aan met artikel 72, dat aanbieders van hoog-risico AI een gedocumenteerd plan voor monitoring na het in de handel brengen oplegt. Wat jouw organisatie als gebruiker zelf regelt, lees je in onze uitleg over de EU AI Act voor gebruiksverantwoordelijken.
Voor je iets toetst, bepaal je je meeteenheid. Bereken metrics per functiefamilie, per functieniveau of per instroombatch, dus een afgebakende periode met sollicitanten die onder dezelfde assessmentconfiguratie zijn beoordeeld. Leg vast hoe je batches definieert, zodat elke meting te herhalen is. Voor stabiele uitkomsten is ongeveer 30 kandidaten per subgroep per batch een praktische ondergrens bij metrics op basis van proporties. Daaronder worden de betrouwbaarheidsintervallen te breed om op te handelen.
Selectieratio en de viervijfderegel. Bereken voor elke beschermde groep de selectieratio, dus het aantal geselecteerde kandidaten op een beslismoment gedeeld door het totale aantal sollicitanten uit die groep. Deel daarna de selectieratio van de groep die je bekijkt door die van de groep met de hoogste ratio. Ligt die verhouding onder 0,80, dan geeft de viervijfderegel uit de EEOC-richtlijnen een signaal van mogelijke nadelige impact en volgt een review. Dit geldt voor elke fase in de funnel. Het assessment, de shortlist, de uitnodiging voor een gesprek en de aanname.
Selectieratio per beslismoment. Kijk niet alleen naar de laatste stap. Een verschil dat bij de aanname klein lijkt, kan zich over meerdere eerdere selectiemomenten hebben opgebouwd. Volg de selectieratio op elk beslismoment apart.
Gemiddelde en mediane scores per subgroep. Geeft het assessment een doorlopende score, bereken dan per subgroep het gemiddelde en de mediaan met een 95%-betrouwbaarheidsinterval. Rapporteer Cohen's d als effectgrootte naast elke significantietoets. Effectgrootte telt, omdat een statistisch significant verschil in de praktijk klein kan zijn, en een groot verschil in kleine batches statistisch onzichtbaar kan blijven.
Kalibratie. Voorspelt de score functieprestatie, deel de scores dan op in tienden (decielen) en vergelijk per deciel de werkelijke uitkomsten tussen subgroepen. Denk aan behoud na 90 dagen, beoordelingen van de manager of het afronden van een training. Halen kandidaten uit groep A met een score van 70 tot 79 in 60% van de gevallen een goede uitkomst en kandidaten uit groep B in dezelfde band maar in 40%, dan is het model per groep verkeerd gekalibreerd. Elke vaste drempel geeft dan structureel ongelijke foutpercentages.
Foutpercentages per groep. Heb je een objectief criterium voor "geschikt", bereken dan per subgroep het percentage vals-positieven (ongeschikte kandidaten die doorgaan) en vals-negatieven (geschikte kandidaten die afvallen). Een gelijke nauwkeurigheid over het geheel kan scheve foutpercentages verbergen die één groep onevenredig raken.
De viervijfderegel is een vuistregel om te signaleren, geen statistische toets. In kleine batches geeft hij valse alarmen en in grote batches mist hij echte effecten. De statistische toets levert het bewijs.
Vergelijk je selectieratio's (door of niet door, twee groepen), gebruik dan een z-toets voor twee proporties, of Fisher's exacte toets bij kleine aantallen. Rapporteer de p-waarde, het 95%-betrouwbaarheidsinterval op het verschil in proporties en de odds ratio of het relatieve risico als effectgrootte.
Vergelijk je doorlopende scores, gebruik dan Welch's t-toets (die geen gelijke varianties veronderstelt) of de Mann-Whitney U-toets bij niet-normale verdelingen. Rapporteer Cohen's d met het betrouwbaarheidsinterval.
Toets je meerdere subgroepen, meerdere beslismomenten en meerdere functiefamilies tegelijk, dan neemt de kans op toevalstreffers snel toe. Pas een correctie toe voor meervoudig toetsen, zoals Benjamini-Hochberg of Bonferroni, en leg vast welke je kiest en waarom. Kies je bewust voor geen correctie, onderbouw dat dan. Bijvoorbeeld omdat een gemist signaal in jouw context zwaarder weegt dan een vals alarm.
Verdeel je beslislogica in drie niveaus.
Eén valkuil verdient extra aandacht. Proxykenmerken kunnen bias veroorzaken die je met gemiddelde nauwkeurigheid nooit ziet. Hangt een kenmerk samen met groepslidmaatschap, zoals postcode, bepaald taalgebruik of reactiesnelheid op bepaalde vraagtypes, dan kan het model nadelige impact geven terwijl de totale nauwkeurigheid er gezond uitziet. Daarom is uitsplitsen per groep, zoals NIST AI RMF MEASURE 2.2 voorschrijft, geen optie maar een vereiste. Welke subgroepcijfers je bij een leverancier opvraagt, staat in ons overzicht van wat een leverancier moet aanleveren bij een AI-audit.
Neem één instroombatch van 400 sollicitanten die een geautomatiseerd screeningsassessment doorlopen voor een logistieke functie. Je volgt twee subgroepen, groep A (200 sollicitanten) en groep B (200 sollicitanten).
Stap 1. De viervijfde-verhouding. Groep A komt voor 50% door (100 van 200). Groep B voor 35% (70 van 200). De verhouding is 0,35 gedeeld door 0,50, dus 0,70. Dat ligt onder 0,80, dus de viervijfderegel geeft een signaal van mogelijke nadelige impact. Niveau signaal bereikt.
Stap 2. De z-toets voor twee proporties. Het verschil in selectieratio is 0,15 (50% min 35%). De z-toets geeft z = 3,03 en p = 0,002. Het 95%-betrouwbaarheidsinterval op het verschil loopt van 0,05 tot 0,24 en sluit nul dus uit. Niveau onderzoek bereikt.
Stap 3. De effectgrootte. Omgerekend naar een odds ratio is dat (100/100) gedeeld door (70/130), dus 1,86. Kandidaten uit groep A hebben ruwweg 86% hogere odds om door te komen dan kandidaten uit groep B. Dat is een verschil dat er in de praktijk toe doet, geen statistisch toeval.
Stap 4. Gemiddelde scores met betrouwbaarheidsintervallen. Groep A scoort gemiddeld 68,2 (95%-interval 66,5 tot 69,9). Groep B scoort gemiddeld 62,7 (95%-interval 60,9 tot 64,5). De intervallen overlappen niet, dus het verschil is waarschijnlijk geen ruis. Cohen's d is 0,43, een middelgroot effect.
Stap 5. De kalibratiecheck. In de scoreband 60 tot 69 had groep A na aanname een behoud na zes maanden van 78%. Groep B in dezelfde band kwam op 75%. Daar zit geen betekenisvol kalibratieverschil. Dat wijst erop dat de drempel om door te gaan te hoog ligt, niet dat de score per groep verkeerd gekalibreerd is. Je hebt dus een drempelprobleem en geen trainingsprobleem.
Het niveau ingrijpen is bereikt. De passende reactie is de drempel herzien en nagaan of een lagere drempel voor alle kandidaten (niet alleen voor groep B) de functierelevantie behoudt en het verschil verkleint.
Elke monitoringronde levert een vast bewijsrecord op. Dit zijn de velden die je minimaal nodig hebt om je aanpak tegenover een toezichthouder te verdedigen.
| Veld | Inhoud |
|---|---|
| Batch-ID | Unieke code en periode |
| Definitie subgroep | Beschermd kenmerk en hoe het is verzameld of afgeleid |
| Assessmentversie | Naam van de tool, versie en configuratie |
| Steekproefgrootte | Aantal per subgroep |
| Selectieratio per subgroep | Exacte cijfers |
| Viervijfde-verhouding | Berekende waarde en signaal ja of nee |
| Toetsgrootheid en p-waarde | Soort toets, z-, F- of U-waarde en p-waarde |
| 95%-interval op het verschil | Onder- en bovengrens |
| Effectgrootte | Cohen's d, odds ratio of relatief risico |
| Uitkomst kalibratiecheck | In orde of signaal, per scoreband |
| Bereikt niveau | Signaal, onderzoek of ingrijpen |
| Genomen actie | Drempel aangepast, hertraind of opgeschaald naar menselijke review |
| Status | Open, in behandeling of gesloten |
Ingrijpen is niet altijd hertrainen. De juiste aanpak hangt af van waar in het systeem het verschil ontstaat.
Op het niveau van data en proces onderzoek je of elk onderdeel van het assessment echt iets zegt over de functie, of bepaalde wervingskanalen een scheve instroom opleveren, en of de formulering van prompts of beoordelingscriteria bepaalde taal- of demografische groepen bevoordeelt.
Op het niveau van het model kun je de drempel aanpassen (de meest gebruikte ingreep bij kalibratieproblemen), de data herwegen bij hertraining, de scores achteraf kalibreren, of trainen met een doel dat nadelige impact expliciet afstraft.
Op het niveau van beleid voer je een gestructureerde menselijke review in voor kandidaten die net rond de drempel scoren, richt je een formele bezwaar- en herstelprocedure in en leg je vast hoe je met uitzonderingen omgaat.
Leg je triggers vooraf vast, zodat beslissingen niet per geval worden genomen.
Volgt er een hertraining, dan moet je de fairness-uitkomsten van voor de hertraining kunnen reproduceren (zet data en code vast op versie), het nieuwe model voor release volledig testen, evalueren, verifiëren en valideren (TEVV), en vastleggen welke metric de hertraining uitlokte en of het nieuwe model het verschil oplost zonder de functierelevantie te verliezen.
Een monitoringjob in productie draait op een vast ritme, meestal maandelijks of per batch, en voedt zowel een dashboard als een auditlog. De stappen zijn deze.
1. Haal de pipelinedata op voor de batchperiode (kandidaat-ID's,
   subgroepkenmerken, beslisuitkomsten, scores, tijdstempels).
2. Bereken de selectieratio per subgroep per beslismoment.
3. Bereken de viervijfde-verhoudingen en markeer alles onder 0,80.
4. Draai de z-toets voor twee proporties (of Fisher exact bij n < 30)
   en bereken 95%-intervallen en odds ratios.
5. Bereken gemiddelde scores per subgroep, draai Welch's t-toets
   en bereken Cohen's d met het 95%-interval op het verschil.
6. Doe de kalibratiecheck, groepeer uitkomsten per scoredeciel
   en subgroep en vergelijk werkelijke met verwachte percentages.
7. Bereken driftindicatoren (PSI of KS per belangrijk kenmerk).
8. Schrijf alle uitkomsten met batchgegevens en assessmentversie
   weg naar het auditlog.
9. Zet alerts uit op het bereikte niveau.
In Python ziet de kern van de proportietoets er zo uit.
from statsmodels.stats.proportion import proportions_ztest, confint_proportions_2indep
from scipy.stats import fisher_exact

z, p = proportions_ztest([100, 70], [200, 200])

# 95%-betrouwbaarheidsinterval op het verschil
ci_low, ci_high = confint_proportions_2indep(
    100, 200, 70, 200, method="newcomb", alpha=0.05
)
Bij kleine steekproeven gebruik je fisher_exact([[100, 100], [70, 130]]) uit scipy.stats.
Een dashboard voor fairness-monitoring heeft vijf panelen.
Laat een alert pas doorstromen naar het niveau onderzoek als zowel de metric over de grens gaat als de toets het bevestigt. Een alert op alleen de viervijfde-verhouding in een batch van 40 sollicitanten is waarschijnlijk ruis. Een alert op de verhouding én een significante toets in een batch van 300 onderzoek je meteen.
Subgroepgegevens opslaan voor fairness-monitoring moet passen bij de AVG-beginselen van dataminimalisatie en doelbinding. In de praktijk bewaar je statistieken op batchniveau (aantallen, ratio's, toetsuitkomsten) en geen subgroepkenmerken per persoon langer dan de verwerking duurt. Pseudonimiseer kandidaatgegevens voor je analyses draait, leg bewaartermijnen voor ruwe scoredata vast en documenteer de grondslag voor het verwerken van bijzondere persoonsgegevens (meestal een specifieke uitzondering onder artikel 9 AVG voor gelijkheidsmonitoring). Of je daarvoor een DPIA nodig hebt, lees je in ons artikel over de DPIA bij AI-assessments.
Een platform dat met deze eisen is gebouwd, maakt dit een stuk eenvoudiger. Selection Lab slaat persoonsgegevens op in Frankfurt met bewaartermijnen volgens de AVG en gebruikt lokale taalmodellen om persoonlijke informatie uit gesprekslogs te halen voordat die verder worden verwerkt. Zo bouw je een audittrail voor fairness-monitoring zonder herleidbare bijzondere gegevens per kandidaat te bewaren, en dat is de juiste opzet voor een monitoringprogramma dat jaren meegaat. Omdat SmartChat direct koppelt met je ATS, wordt de funneldata op elk beslismoment op dezelfde manier vastgelegd. Compliance-teams hebben dan een gestructureerde databron om hun monitoring op te draaien, zonder losse exports.
Fairness-monitoring schuift vaak naar achteren omdat teams denken dat er eerst een groot dataproject nodig is. Dat klopt zelden. Een organisatie die een gestructureerd assessment invoert, kan binnen weken na de livegang selectieratio's berekenen en de eerste proportietoetsen draaien. Voorwaarde is dat je subgroepen, beslismomenten en batchperiodes bij de inrichting vastlegt en niet achteraf.
Bij Selection Lab duurt de implementatie doorgaans twee tot tien weken. In die periode richt je de monitoring parallel aan de uitrol in. Je zet het vastleggen van subgroepen in het ATS aan, bevestigt het schema van het auditlog en plant de eerste batchreview aan het eind van de eerste volledige instroomcyclus. Wie pas na de livegang aan monitoring denkt, mist bijna altijd de eerste batches.
De opbrengst is niet alleen compliance. Wie de eerlijkheid van de assessmentpipeline monitort, ziet ook waar de funnel lekt. Vallen kandidaten uit groep B vaker af bij het assessment dan de rest, dan is dat een mogelijk signaal van nadelige impact en tegelijk een probleem in de kandidaatervaring. De impactcijfers van Selection Lab laten zien hoe assessmentontwerp en screeningkwaliteit samenhangen. 27% minder uitval van sollicitanten (data van maart 2025) en 21% minder vroeg verloop (data van januari 2024) zijn het soort uitkomsten dat een goed ingericht monitoringprogramma vastlegt, koppelt aan proceswijzigingen en aan de juiste oorzaak toeschrijft.
Voldoen aan NIST AI RMF MEASURE 2.1 tot en met 2.4 en aan de monitoringverplichtingen uit artikel 72 van de EU AI Act vraagt om gedocumenteerd, reproduceerbaar bewijs, niet om losse rapporten. Het template hierboven geeft je de structuur. De monitoringpipeline zorgt voor de automatisering. Wat er een verdedigbare compliance-aanpak van maakt, is governance. Een eigenaar per metric, een vastgelegd escalatiepad van signaal tot ingrijpen, versiebeheer op assessmentconfiguraties en documentatie die elke ingreep terugkoppelt aan het statistische bewijs dat hem uitlokte.
De organisaties die het rustigst blijven bij toezicht zijn niet degene met de meeste audits. Het zijn de organisaties die doorlopend monitoren en per batch kunnen laten zien dat ze wisten wat hun systeem deed, afwijkingen onderzochten en op het bewijs handelden. Wil je zien hoe dat er in jouw selectieproces uitziet, vraag dan een demo aan.
De viervijfderegel vergelijkt selectieratio's tussen groepen. Ligt de selectieratio van een beschermde groep onder 80% van die van de groep met de hoogste ratio, dan is dat een signaal van mogelijke nadelige impact. Het is een vuistregel en geen bewijs. Bevestig het verschil altijd met een statistische toets en een effectgrootte.
Doorlopend, op een vast ritme. Meestal is dat maandelijks of per instroombatch. Een eenmalige audit voor de livegang is niet genoeg, omdat instroom, drempels en beoordelingscriteria veranderen en elke wijziging de uitkomsten per groep kan verschuiven.
Als praktische ondergrens ongeveer 30 kandidaten per subgroep per batch voor metrics op basis van proporties. Bij kleinere aantallen worden de betrouwbaarheidsintervallen te breed om op te handelen en gebruik je Fisher's exacte toets in plaats van de z-toets.
Niet altijd. Kijk eerst waar het verschil ontstaat. Vaak ligt de oplossing in een aangepaste drempel, een kalibratiecorrectie, een menselijke review rond de drempel of een ander wervingskanaal. Hertrainen is pas aan de orde als het model zelf de oorzaak is, en dan met volledige tests voor de release.
Ja, onder voorwaarden. Je hebt een grondslag nodig, meestal een uitzondering onder artikel 9 AVG voor gelijkheidsmonitoring. Bewaar bij voorkeur alleen statistieken op batchniveau, pseudonimiseer kandidaatgegevens voor de analyse en leg vaste bewaartermijnen vast.